Zum Inhalt springen
Über mich

Physiker. Data Engineer. Umsetzer.

Promovierter Physiker, Gründer und Principal Consultant für Data & AI mit mehr als zehn Jahren Erfahrung. Ich verantworte Daten- und KI-Lösungen Ende-zu-Ende – von der Analyse und Architektur über Datenpipelines und KI-Komponenten bis zum sicheren, produktiven Betrieb.

Data- & KI-Architektur/Data Engineering/Automatisierung/Applied AI

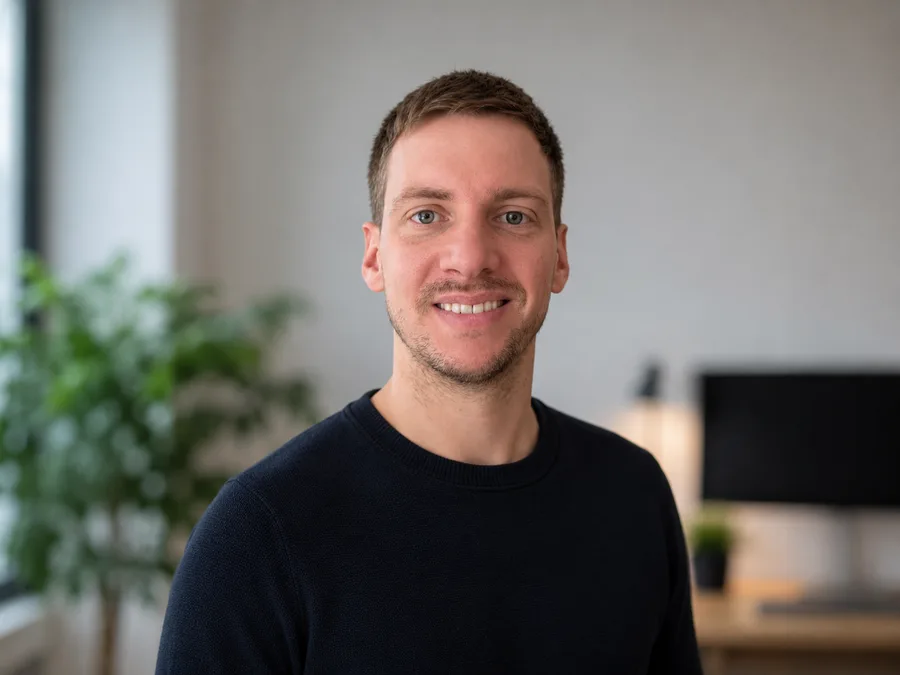
Porträt von Dr. Oliver Köhn

Dr. Oliver Köhn

Principal Consultant Data & AI

Saarbrücken · remote
  • Dr. rer. nat.Physik · sehr gut
  • 3× MicrosoftCertified
  • 10+ JahreData & AI
  • 10+Jahre ErfahrungData, Cloud & KI
  • 18dokumentierte Projekteunten im Werdegang
  • 5berufliche StationenBeratung, Finanzen, Cloud
  • 3×Microsoft CertifiedAzure & Fabric
  • Dr.Promotion PhysikAbschluss „sehr gut“
Werdegang

Stationen, Projekte und was dabei entstanden ist.

Statt Referenzlogos: die Projekte selbst. Zu jedem Projekt finden Sie meine Rolle und Verantwortung, die Ausgangslage, Architektur und Umsetzung, die erzielte Wirkung und die eingesetzten Technologien – aufklappbar.

  1. 12/2024 – heuteaktuell

    Selbstständig

    Gründer & Principal Consultant Data & AI

    5 Projekte

    Als Gründer berate ich Geschäftsführung und Fachbereiche zu Daten-, Automatisierungs- und KI-Vorhaben und trage die Gesamtverantwortung für deren Umsetzung: von der Analyse der Prozesse und Nutzenpotenziale über Zielarchitektur und Technologieauswahl bis zu Implementierung, Betrieb und Weiterentwicklung. Beratung, Architektur und Lieferung liegen in einer Hand – ohne Übergabeverluste zwischen Konzept und Produktion.

    • Gesamtverantwortung für Analyse, Architektur, Umsetzung, Betrieb und Kundensteuerung
    • Beratung von Geschäftsführung und Fachbereichen zu Priorisierung und Umsetzbarkeit von Daten- und KI-Vorhaben
    • Architektur produktiver RAG-, Dokumenten-, E-Mail- und Assistenzsysteme
    • Souveräne lokale und hybride KI-Architekturen mit austauschbaren Open-Source-Komponenten
    Projekte
    01Architektur und Aufbau einer KI-gestützten E-Mail-Vorgangsverarbeitung

    Rolle & Verantwortung

    Gesamtverantwortung von der Prozessanalyse über Architektur und Implementierung bis zu Bereitstellung und Betrieb. Fachlicher und technischer Ansprechpartner des Kunden über den gesamten Lebenszyklus.

    Ausgangslage

    Ein wiederkehrender Geschäftsprozess beruhte auf frei formulierten E-Mails, aus denen Anliegen, Beteiligte, Referenzen, Fristen und Zuständigkeiten manuell herausgelesen und weitergegeben werden mussten. Gefordert war eine Automatisierung, die unstrukturierte Nachrichten verlässlich in strukturierte Vorgänge überführt, ohne die fachliche Kontrolle aus der Hand zu geben – und die sich an unterschiedliche Datenschutz- und Betriebsanforderungen anpassen lässt.

    Architektur & Umsetzung

    Modulare Architektur aus FastAPI-Backend, PostgreSQL-Persistenz und n8n-Workflow-Integration, in der ein Sprachmodell Anliegen, Personen, Referenzen, Fristen, Prioritäten und mögliche Zuständigkeiten als schemagebundene, strukturierte Ausgabe liefert. Eine Prüfoberfläche macht jedes Extraktionsergebnis nachvollziehbar und hält die fachliche Kontrolle beim Menschen; aus den bestätigten Ergebnissen entstehen automatisch Aufgaben, Folgeprozesse und Benachrichtigungen. LiteLLM dient als Modell-Gateway: Kommerzielle Modell-APIs, europäische Dienste oder lokal über Ollama betriebene Modelle sind austauschbar, sodass Datenschutz, Kosten und Qualität je Einsatzumgebung bewusst abgewogen werden können. Die Bereitstellung erfolgt containerisiert mit Docker.

    Wirkung

    Manuelles Sichten und Weiterleiten wird durch einen strukturierten, nachvollziehbaren Vorgangsprozess ersetzt. Die anbieterneutrale Architektur erlaubt den Einsatz auch unter strengen Datenschutzanforderungen, ohne die Anwendung neu bauen zu müssen.

    PythonFastAPIPostgreSQLLLMsstrukturierte Ausgabenn8nREST APIsDockerOllamaLiteLLM
    02Ende-zu-Ende-Automatisierung der Dokumentenverarbeitung über mehrere Systeme

    Rolle & Verantwortung

    Gesamtverantwortung für Prozessdesign, Integrationsarchitektur, Umsetzung und Betrieb des systemübergreifenden Workflows.

    Ausgangslage

    Eingehende PDFs und weitere Dokumente durchliefen mehrere Systeme – Dateiablage, Aufgabenverwaltung, Dokumentation und Team-Kommunikation –, zwischen denen Informationen von Hand übertragen wurden. Ziel war ein durchgängiger, nachvollziehbarer Prozess ohne Medienbrüche auf Basis selbst betreibbarer Open-Source-Systeme.

    Architektur & Umsetzung

    Workflow-Orchestrierung mit n8n: Neue Dokumente in Nextcloud Files werden automatisch erkannt, KI-gestützt analysiert und die extrahierten Informationen strukturiert gespeichert. Über REST-Schnittstellen entstehen daraus Kanban-Aufgaben in Nextcloud Deck, Wissensseiten in Docmost und Benachrichtigungen in Nextcloud Talk. Python-Komponenten kapseln Analyse- und Transformationslogik, die Gesamtlösung läuft containerisiert mit Docker. Jeder Bearbeitungsschritt wird dokumentiert, sodass Status und Herkunft eines Vorgangs jederzeit nachvollziehbar bleiben.

    Wirkung

    Medienbrüche zwischen Ablage, Aufgabenverwaltung, Dokumentation und Kommunikation werden reduziert, Bearbeitungsschritte sind durchgängig nachvollziehbar. Die Kernsysteme bleiben vollständig unter eigener Kontrolle.

    Nextcloud FilesNextcloud DeckNextcloud TalkDocmostn8nPythonLLMsDockerREST APIs
    03Architektur eines internen Wissensassistenten mit Quellennachweis

    Rolle & Verantwortung

    Gesamtverantwortung für Lösungsarchitektur, Berechtigungs- und Betriebskonzept, Implementierung und Bereitstellung der RAG-Anwendung.

    Ausgangslage

    Mitarbeitende benötigten schnellen, verlässlichen Zugriff auf Wissen aus internen Verträgen, Richtlinien und Arbeitsunterlagen. Die Anforderungen gingen über einen generischen Chatbot hinaus: Antworten müssen auf konkrete Fundstellen zurückführbar sein, Zugriffsrechte respektieren und bei Bedarf vollständig auf kontrollierter Infrastruktur entstehen.

    Architektur & Umsetzung

    Retrieval-Augmented-Generation-Architektur mit Dokumentenimport, semantischer Suche über PostgreSQL/pgvector und Orchestrierung mit LangChain und LangGraph; jede Antwort wird mit den verwendeten Dokumenten und Fundstellen ausgegeben. Berechtigungen sind integraler Bestandteil der Architektur und steuern, welche Inhalte in Antworten einfließen. Ein Modellrouting über LiteLLM entkoppelt die Anwendung vom Modellanbieter: Modelle können lokal über Ollama oder vLLM (Hugging Face) betrieben oder flexibel aus internen und externen Quellen angebunden werden. Die Anwendung wird über ein FastAPI-Backend bereitgestellt.

    Wirkung

    Fragen zu internen Unterlagen werden mit belegbaren Antworten und direkten Fundstellen beantwortet – das schafft Vertrauen und Prüfbarkeit. Lokale Betriebsoptionen ermöglichen den Einsatz auch für vertrauliche Dokumente.

    RAGLangChainLangGraphHugging FacevLLMOllamaLiteLLMPostgreSQLpgvectorFastAPI
    04Agentenbasiertes Analyse- und Reporting-System für das Management

    Rolle & Verantwortung

    Gesamtverantwortung für Konzeption, Architektur und Umsetzung – von den Datenpipelines über analytische Modelle und Agentensteuerung bis zu den Dashboards.

    Ausgangslage

    Für Management-Berichte müssen Daten aus mehreren Quellen zusammengeführt, Entwicklungen analysiert und auffällige Kennzahlen eingeordnet werden. Generative KI sollte diesen Prozess unterstützen, ohne die Verlässlichkeit der Zahlen zu gefährden – in Managementberichten ist ein vom Modell erfundener Wert nicht tolerierbar.

    Architektur & Umsetzung

    Architektur aus Datenpipelines (Python, SQL), analytischen Modellen, Dashboards (Power BI, Apache Superset, Grafana) und einem mit LangGraph orchestrierten Agentensystem. Zentrale Designentscheidung ist die strikte Trennung zwischen berechneten Kennzahlen und generierten Erläuterungen: Zahlen entstehen deterministisch in der Datenschicht, das Sprachmodell ordnet sie ein. Werkzeugaufrufe des Agenten sind kontrolliert, Zwischenergebnisse werden nachvollziehbar festgehalten. Ergebnis sind strukturierte Berichtsentwürfe mit Vorschlägen für nächste Analyseschritte.

    Wirkung

    Management-Berichte werden strukturiert vorbereitet und auffällige Entwicklungen schneller eingeordnet. Die Trennung von Kennzahl und Erläuterung macht jede Aussage prüfbar.

    PythonSQLLangGraphAgentic AIPower BIApache SupersetGrafanaREST APIsDocker
    05Voice-RAG-Prototyp: Sprachassistent auf Basis freigegebenen Unternehmenswissens

    Rolle & Verantwortung

    Gesamtverantwortung für Lösungsarchitektur und prototypische Umsetzung, einschließlich Sprachverarbeitung, Wissensanbindung und Betriebskonzept für sensible Inhalte.

    Ausgangslage

    Wiederkehrende interne oder externe Anfragen sollten per Sprache beantwortet werden – auf Basis freigegebener Unternehmensunterlagen statt allgemeinen Modellwissens. Die Herausforderung lag in der Verkettung von Spracherkennung, Wissenssuche und Sprachausgabe zu einem flüssigen Dialog und im kontrollierten Umgang mit sensiblen Dokumenten.

    Architektur & Umsetzung

    Verarbeitungskette aus Speech-to-Text, Retrieval gegen freigegebene Unternehmensunterlagen und Text-to-Speech, angebunden über ein FastAPI-Backend mit WebSocket-Kommunikation. Quellenanzeige und Gesprächsprotokollierung sichern Nachvollziehbarkeit und Auswertbarkeit. Über Ollama und LiteLLM lassen sich Modelle lokal betreiben, sodass sensible Dokumente und Modellkomponenten vollständig auf kontrollierter Infrastruktur laufen können; die Bereitstellung erfolgt containerisiert mit Docker.

    Wirkung

    Der Prototyp demonstriert sprachbasierte Wissensabfragen mit Quellenbezug und schafft eine fundierte Entscheidungsgrundlage für einen produktiven Einsatz – auch unter strengen Vertraulichkeitsanforderungen.
    Speech-to-TextText-to-SpeechRAGOllamaLiteLLMFastAPIWebSocketsDocker
  2. 08/2024 – 11/20244 Monate

    Public Cloud Group

    Senior Data & AI Engineer

    3 Projekte

    Konzeption und Entwicklung produktiver KI- und Datenlösungen im Cloud- und Unternehmensumfeld auf AWS und Azure. Schwerpunkt war die Überführung von Machine-Learning- und GenAI-Anwendungsfällen in skalierbare, betreibbare Architekturen – von wiederverwendbaren Plattformkomponenten über validierte Dokumentenanalyse bis zu Predictive Analytics für industrielle Prozesse.

    • Mitgestaltung einer unternehmensweiten Generative-AI-Plattform auf AWS
    • Validierte, rückverfolgbare Dokumentenanalyse für Reporting- und Prüfprozesse
    • Predictive Analytics für die industrielle Instandhaltung auf Basis SAP-naher Daten
    Projekte
    01Konzeption und Entwicklung einer unternehmensweiten Generative-AI-Plattform

    Rolle & Verantwortung

    Mitwirkung an Konzeption und Entwicklung der zentralen Plattform – von wiederverwendbaren Komponenten für Modellzugriff, Prompt-Verwaltung und strukturierte Ausgaben bis zu Skalierung, Zugriffskontrolle und Cloud-Bereitstellung.

    Ausgangslage

    Fachbereiche wollten generative KI in bestehende Content- und Freigabeprozesse integrieren. Ohne zentrale Plattform hätte jeder Anwendungsfall eigene Infrastruktur, eigene Modellanbindungen und eigene Sicherheitsmechanismen erfordert – mit entsprechendem Aufwand und uneinheitlicher Governance.

    Architektur & Umsetzung

    Plattformansatz auf AWS mit wiederverwendbaren Diensten für Modellzugriff, Prompt-Verwaltung, strukturierte Ausgaben und die Integration unterschiedlicher Datenquellen, bereitgestellt als REST-APIs auf Basis von Python, FastAPI und Docker. Querschnittsthemen wie Skalierung, Zugriffskontrolle und Monitoring wurden auf Plattformebene gelöst statt in jedem Anwendungsfall erneut. RAG-Bausteine binden unternehmensinterne Inhalte an; die Auslieferung erfolgt über CI/CD in die Cloud-Umgebung.

    Wirkung

    Fachbereiche können GenAI-Funktionen in ihre bestehenden Prozesse integrieren, ohne je Anwendungsfall neue Infrastruktur aufzubauen. Zentrale Zugriffskontrolle und Monitoring schaffen die Grundlage für einen kontrollierten, skalierbaren Einsatz im Unternehmen.

    AWSPythonFastAPIDockerLLM APIsRAGREST APIsCI/CDMonitoring
    02LLM-gestützte Dokumentenanalyse mit Validierung für Reporting- und Prüfprozesse

    Rolle & Verantwortung

    Verantwortung für Entwicklung und Integration der Analyselösung – von der Extraktionslogik über die Validierungsregeln bis zur Anbindung an die bestehende Azure-Umgebung.

    Ausgangslage

    Umfangreiche, teils unstrukturierte Dokumente mussten für nachgelagerte Reporting- und Prüfprozesse ausgewertet werden. In diesem Kontext reichen plausibel klingende KI-Ergebnisse nicht aus: Jede extrahierte Information muss validiert und auf die ursprüngliche Dokumentstelle zurückführbar sein.

    Architektur & Umsetzung

    Verarbeitungskette zur Extraktion und Klassifikation relevanter Inhalte mit Sprachmodellen und strikt strukturierten Ausgaben, bereitgestellt über FastAPI. Validierungsregeln prüfen die Ergebnisse, bevor sie in nachgelagerte Prozesse übergehen. Jedes Ergebnis ist der ursprünglichen Dokumentstelle zugeordnet, sodass Prüfende Aussagen direkt am Original verifizieren können. Die Lösung ist in die bestehende Azure-Umgebung und vorhandene Datenprozesse integriert.

    Wirkung

    Unstrukturierte Dokumente werden in prüffähige, strukturierte Daten überführt. Die durchgängige Rückverfolgbarkeit bis zur Quelle macht die Ergebnisse für Reporting- und Prüfprozesse belastbar.

    AzurePythonLLMsDokumentenverarbeitungFastAPIstrukturierte AusgabenDatenvalidierung
    03Ausfallprognose für industrielle Maschinen auf Basis von SAP- und Sensordaten

    Rolle & Verantwortung

    Entwicklung bzw. Weiterentwicklung des Prognosesystems mit Verantwortung für Datenpipeline, Modellierung und die Bereitstellung interpretierbarer Ergebnisse für den Betrieb.

    Ausgangslage

    Mögliche Maschinenausfälle sollten frühzeitig erkannt werden, damit Instandhaltung vorausschauend statt reaktiv geplant werden kann. Die relevanten Betriebs-, Zustands- und Sensordaten lagen verteilt in SAP-nahen und weiteren Quellen vor und mussten erst zu einer belastbaren Datengrundlage zusammengeführt werden.

    Architektur & Umsetzung

    ETL-Strecke in Azure, die Betriebs-, Zustands- und Sensordaten zusammenführt, bereinigt und für Vorhersagemodelle aufbereitet. Entwicklung und Weiterentwicklung der Machine-Learning-Modelle zur Ausfallprognose sowie Monitoring von Datenverarbeitung und Ergebnissen. Besonderes Augenmerk lag auf der Interpretierbarkeit, damit Fachanwender Risiken nachvollziehen und Maßnahmen begründet ableiten können.

    Wirkung

    Fachanwender können Ausfallrisiken priorisieren und Wartungsmaßnahmen gezielter planen. Die Prognosen sind in betriebliche Abläufe eingebunden, statt isoliert im Analysewerkzeug zu verbleiben.

    AzurePythonSAPPredictive AnalyticsMachine LearningETLMonitoring
  3. 2023 – 2024

    Master of Science in Data Science

    IU International University of Applied Sciences

    Thesis „Data-Science solution with a business approach“

  4. 07/2022 – 07/20242 Jahre 1 Monat

    adesso Schweiz

    Senior Data Consultant

    4 Projekte

    Konzeption und Umsetzung von Cloud-Datenplattformen, Analytics-Lösungen und Machine-Learning-Anwendungen im Microsoft-Azure-Umfeld. Beratung von Fachbereichen und technischen Teams an der Schnittstelle zwischen Geschäftsanforderungen und Architektur sowie Umsetzung produktiver Daten- und Analyseprozesse – von der Migration historisch gewachsener Strukturen bis zu Predictive Maintenance und NLP.

    • Architektur und Aufbau von Azure-Datenplattformen mit automatisierten ETL/ELT-Pipelines
    • Cloud-Migration und Modernisierung historisch gewachsener Reporting-Strukturen
    • Predictive Maintenance und NLP – von der Datenintegration bis zur Bereitstellung
    • Self-Service-Analytics mit Power BI und Tableau
    Projekte
    01Predictive-Maintenance-System für industrielle Anlagen – von der Datenquelle bis zum Dashboard

    Rolle & Verantwortung

    Umsetzung der vollständigen Verarbeitungskette – Datenintegration, Feature Engineering, Modellentwicklung und -bewertung sowie Bereitstellung der Ergebnisse für Fachanwender.

    Ausgangslage

    Drohende Maschinenausfälle sollten erkannt werden, bevor sie zu ungeplanten Stillständen führen. Die Datengrundlage war heterogen: Historische Betriebsdaten, Sensordaten und Wartungsinformationen mussten zusammengeführt, bereinigt und für Machine Learning nutzbar gemacht werden.

    Architektur & Umsetzung

    Datenintegration und skalierbare Aufbereitung auf Basis von Azure Data Factory, Azure Synapse Analytics und Azure Databricks mit Spark. Feature Engineering, Entwicklung und systematische Bewertung der Prognosemodelle in Python als Voraussetzung für die Bereitstellung. Die Vorhersagen wurden in Analyse- und Reporting-Oberflächen in Power BI integriert, sodass sie unmittelbar in die Arbeit der Fachanwender einfließen.

    Wirkung

    Fachanwender erhalten Prognosen zu drohenden Ausfällen direkt in ihren gewohnten Reporting-Oberflächen. Die durchgängige Verarbeitungskette macht das System wiederholbar betreibbar statt zu einer einmaligen Analyse.

    PythonAzure Synapse AnalyticsAzure Data FactoryAzure DatabricksSparkMachine LearningPower BI
    02Architektur und Aufbau einer zentralen Azure-Analyseplattform

    Rolle & Verantwortung

    Konzeption der Plattformarchitektur und Umsetzung der automatisierten Datenpipelines, des Datenmodells und der Analytics-Schicht für unterschiedliche Fachbereiche.

    Ausgangslage

    Geschäftsdaten lagen verteilt in mehreren operativen Systemen vor; eine einheitliche, verlässliche Sicht für Reporting und Analyse fehlte. Benötigt wurde eine zentrale Plattform, die unterschiedliche Fachbereiche mit konsistenten Daten versorgt und zugleich wartbar und erweiterbar bleibt.

    Architektur & Umsetzung

    Cloudbasierte Plattform mit Azure Data Factory, Azure Synapse und Databricks: Automatisierte ETL- und ELT-Prozesse vereinheitlichen die Quelldaten und führen sie in einem konsistenten Datenmodell zusammen. Die Pipelines sind auf Wiederverwendbarkeit ausgelegt und werden über CI/CD ausgeliefert; Datenqualität und ein nachvollziehbarer Betrieb sind fester Bestandteil der Architektur. Darauf aufbauend entstanden Dashboards und Self-Service-Analytics-Lösungen mit Power BI und Tableau.

    Wirkung

    Fachbereiche arbeiten auf einer gemeinsamen, konsistenten Datengrundlage und können Analysen im Self-Service erstellen. Wiederverwendbare Pipelines erleichtern die Anbindung weiterer Datenquellen und Anwendungsfälle.

    Azure Data FactoryAzure SynapseDatabricksSQLSparkPower BITableauCI/CD
    03Migration von Legacy-Datenstrukturen und Modernisierung des Reportings auf Azure

    Rolle & Verantwortung

    Analyse der Bestandslandschaft, Vereinheitlichung der Datenmodelle und Durchführung der schrittweisen Migration von Datenquellen, Transformationslogik und Berichten.

    Ausgangslage

    Historisch gewachsene Daten- und Reporting-Strukturen mit verteilter Transformationslogik und unzureichend dokumentierten Abhängigkeiten erschwerten Wartung und Weiterentwicklung. Die Modernisierung musste schrittweise erfolgen, um Risiken für das laufende Reporting zu begrenzen.

    Architektur & Umsetzung

    Systematische Analyse bestehender Datenquellen, Transformationslogik und Berichte als Grundlage der Migrationsplanung sowie Dokumentation aller Abhängigkeiten. Bereinigung und Vereinheitlichung der Datenmodelle, schrittweise Überführung in eine Azure-basierte Plattform und Optimierung der Abfragen mit SQL und Python. Bereitstellung des Reportings in Power BI auf der konsolidierten Datenbasis.

    Wirkung

    Eine konsolidierte, dokumentierte Datenbasis ersetzt historisch gewachsene Strukturen und ist belastbarer und wartbarer. Sie bildet die Grundlage für Reporting, Analytics und spätere KI-Anwendungsfälle.

    AzureSQLPythonETLDatenmodellierungCloud-MigrationPower BI
    04NLP-basierte Auswertung von Kundenfeedback zur Früherkennung von Problemfeldern

    Rolle & Verantwortung

    Umsetzung der gesamten Kette – Textaufbereitung, NLP-Modellierung, Datenpipeline und Visualisierung für die Fachbereiche.

    Ausgangslage

    Kundenkommentare und Freitextfeedback enthielten wertvolle Hinweise auf Problemfelder, ließen sich manuell aber nicht systematisch auswerten. Fachbereiche benötigten einen strukturierten Überblick über Themen, Stimmungen und wiederkehrende Inhalte.

    Architektur & Umsetzung

    Skalierbare Verarbeitung auf Azure Databricks mit Spark: Texte werden aufbereitet, thematisch klassifiziert und per Sentiment-Analyse bewertet, wiederkehrende Inhalte werden identifiziert. Die Ergebnisse fließen über eine Datenpipeline in ein Power-BI-Dashboard, das Entwicklungen sichtbar macht. Damit verbindet die Lösung NLP-Verarbeitung, Datenpipeline und Business Intelligence in einer durchgängigen Architektur.

    Wirkung

    Fachbereiche erkennen Entwicklungen und relevante Problemfelder schneller – auf Basis systematisch ausgewerteter Daten statt einzelner Beobachtungen.

    Azure DatabricksPythonNLPSentiment AnalysisPower BISpark
  5. 08/2020 – 07/20222 Jahre

    Finanz Informatik

    IT-Architekt

    3 Projekte

    Architektur und Entwicklung datengetriebener Analyse-, Risiko- und Simulationslösungen im regulierten Finanzumfeld. Verbindung quantitativer Modelle mit stabilen, nachvollziehbaren Daten- und Anwendungsarchitekturen sowie fundierte Bewertung neuer Berechnungsverfahren wie Quantum Computing hinsichtlich Machbarkeit und Nutzen für den Unternehmenseinsatz.

    • Architektur für reproduzierbare Risiko- und Szenarioberechnungen im regulierten Umfeld
    • Datengetriebene Entscheidungsunterstützung durch Analyse und Simulation
    • Technologiebewertung Quantum Computing für den Unternehmenseinsatz
    Projekte
    01Architektur einer Plattform für reproduzierbare Risiko- und Szenarioanalysen

    Rolle & Verantwortung

    Verantwortung für die technische Architekturkonzeption – Datenbereitstellung, Ausführung der Simulationsläufe, Ergebnisspeicherung und Schnittstellen zur fachlichen Analyse.

    Ausgangslage

    Datenintensive Risiko- und Szenarioberechnungen erfordern das Zusammenspiel unterschiedlicher Markt-, Bestands- und Referenzdaten. Im regulierten Finanzumfeld müssen Ergebnisse jederzeit nachvollziehbar und reproduzierbar sein – eine Anforderung, die Architektur und Datenhaltung maßgeblich prägt.

    Architektur & Umsetzung

    Architektur mit Datenpipelines zur Aufbereitung und Bereitstellung der Eingangsdaten, containerisierter Ausführung der Simulationsläufe und strukturierter Speicherung der Ergebnisse. REST-Schnittstellen binden die Plattform an die anschließende Analyse durch Fachanwender an. Datenqualitätsprüfungen und eindeutig zuordenbare Berechnungsstände sichern die Reproduzierbarkeit jeder Auswertung.

    Wirkung

    Fachanwender können verschiedene Szenarien strukturiert durchführen und auswerten, jeder Berechnungsstand bleibt nachvollziehbar – eine Voraussetzung für belastbare Risikoaussagen im regulierten Umfeld.

    PythonSQLquantitative ModelleSimulationDatenpipelinesREST APIsContainerisierung
    02Simulationsbasierte Entscheidungsunterstützung im Finanzumfeld

    Rolle & Verantwortung

    Verantwortung von der fachlichen Strukturierung der Fragestellung über die technische Modellierung bis zur entscheidungsgerechten Aufbereitung der Ergebnisse.

    Ausgangslage

    Unterschiedliche fachliche Handlungsoptionen sollten quantitativ bewertet und vergleichbar gemacht werden. Die zugrunde liegenden Berechnungen waren komplex und datenintensiv, ihre Ergebnisse mussten für Entscheidungsträger dennoch verständlich und belastbar sein.

    Architektur & Umsetzung

    Strukturierung der fachlichen Fragestellung und Übersetzung in statistische Modelle und Szenarioanalysen. Verarbeitung großer Datenmengen mit Python und SQL sowie Verdichtung der Berechnungsergebnisse zu aussagekräftigen Kennzahlen und Visualisierungen. Bereitstellung der Ergebnisse über Reporting für Entscheidungsträger.

    Wirkung

    Komplexe Berechnungsergebnisse werden zu einer transparenten, vergleichbaren Entscheidungsgrundlage verdichtet.

    PythonSQLstatistische ModellierungSzenarioanalyseReportingDatenvisualisierung
    03Technologiebewertung Quantum Computing: Proof of Concept für Optimierung und Simulation

    Rolle & Verantwortung

    Konzeption, Durchführung und Bewertung des Proof of Concept einschließlich der realistischen Einordnung der Technologie für den Unternehmenseinsatz.

    Ausgangslage

    Quantenbasierte und quantum-inspired Verfahren versprechen Vorteile bei Optimierungs- und Simulationsproblemen. Für eine fundierte Technologieentscheidung war zu klären, inwieweit ausgewählte Problemstellungen damit tatsächlich besser bearbeitet werden können als mit etablierten klassischen Verfahren.

    Architektur & Umsetzung

    Auswahl geeigneter Optimierungs- und Simulationsprobleme, Implementierung quantenbasierter bzw. quantum-inspired Ansätze in Python und systematischer Vergleich mit klassischen Referenzverfahren. Neben dem Algorithmus wurden Datenaufbereitung, Schnittstellen und reproduzierbare Tests berücksichtigt, um Machbarkeit und Integrationsaufwand realistisch bewerten zu können.

    Wirkung

    Eine nüchterne, belastbare Einordnung von technischer Machbarkeit und möglichem Nutzen – als Grundlage für weitere Technologieentscheidungen statt hype-getriebener Erwartungen.

    PythonQuantum ComputingOptimierungSimulationklassische Vergleichsverfahren
  6. 2017 – 2020

    Promotion zum Dr. rer. nat. in Physik

    Universität des Saarlandes und University of Wisconsin–Madison

    Thesis „Statistical analysis of bacterial locomotion“

    Abschluss: sehr gut
  7. 01/2016 – 06/20171 Jahr 6 Monate

    d-fine

    Consultant

    3 Projekte

    Entwicklung analytischer Lösungen für Compliance, Stresstests, Datenqualität und Entscheidungsunterstützung im regulierten Finanzumfeld. Überführung manueller Analyse- und Reporting-Arbeit in automatisierte, reproduzierbare und prüfbare Abläufe.

    • Regelbasierte Compliance- und Kontrollauswertungen mit Fokus auf Datenqualität
    • Quantitative Stresstest- und Szenarioanalysen
    • Automatisierung analytischer und regulatorischer Prozesse
    Projekte
    01Automatisierte Compliance- und Kontrollauswertungen auf Basis fachlicher Regelwerke

    Rolle & Verantwortung

    Entwicklung der Auswertungslogik und der automatisierten Datenverarbeitung – von der Vereinheitlichung der Quellen bis zur Integration in Berichts- und Prüfprozesse.

    Ausgangslage

    Große Bestände mussten auf definierte Compliance- und Kontrollkriterien geprüft werden. Die Daten stammten aus unterschiedlichen Quellen, die Auswertung beruhte auf manueller Excel- und Datenbankarbeit – aufwendig und schwer reproduzierbar.

    Architektur & Umsetzung

    Vereinheitlichung und Validierung der Daten aus unterschiedlichen Quellen sowie Umsetzung der fachlichen Prüfregeln in reproduzierbare Python- und SQL-Abläufe. Datenqualitätsprüfungen stellen sicher, dass Auswertungen auf verlässlicher Basis erfolgen. Die Ergebnisse werden für Fachanwender nachvollziehbar aufbereitet und in wiederkehrende Berichts- und Prüfprozesse integriert.

    Wirkung

    Manuelle Excel- und Datenbankarbeit wird durch reproduzierbare, automatisierte Prüfabläufe ersetzt, deren Ergebnisse für Fachanwender nachvollziehbar sind.

    PythonSQLDatenqualitätRegelwerkeReportingAutomatisierung
    02Quantitative Stresstest- und Szenarioanalysen

    Rolle & Verantwortung

    Implementierung der Berechnungsmodelle sowie Verantwortung für Datenaufbereitung, Plausibilisierung und fachliche Dokumentation der Ergebnisse.

    Ausgangslage

    Die Auswirkungen unterschiedlicher Markt- und Risikoszenarien sollten quantitativ untersucht werden. Im Stresstest-Kontext müssen Eingangsdaten abgestimmt, Berechnungen reproduzierbar und Ergebnisse plausibilisiert und dokumentiert sein.

    Architektur & Umsetzung

    Aufbereitung und Abstimmung der Eingangsdaten, Implementierung der quantitativen Modelle in Python und SQL sowie Simulation der Szenarien. Systematische Plausibilisierung und fachliche Dokumentation sichern Reproduzierbarkeit und Prüfbarkeit. Aufbereitung der Ergebnisse mit Visualisierungen für weiterführende Analysen und Management-Berichte.

    Wirkung

    Plausibilisierte, reproduzierbare Szenarioergebnisse als belastbare Grundlage für weiterführende Analysen und Management-Berichte.

    PythonSQLquantitative ModelleSimulationStresstestsDatenvisualisierung
    03Analytischer Prototyp zur Auswertung von Stimmungen und Freitextinformationen

    Rolle & Verantwortung

    Entwicklung des Prototyps von der Textaufbereitung über die Modellierung bis zur Ergebnisdarstellung.

    Ausgangslage

    Relevante Informationen lagen in unstrukturierten Texten vor und ließen sich mit klassischen, strukturierten Auswertungen nicht erschließen. Ziel war ein Prototyp, der Themen und Stimmungen systematisch sichtbar macht.

    Architektur & Umsetzung

    Aufbereitung und Kategorisierung der Texte sowie Kombination statistischer Analyse mit NLP-Verfahren zur Erkennung von Stimmungen und Themen. Die Ergebnisse wurden so dargestellt, dass fachliche Nutzer sie ohne methodisches Vorwissen interpretieren können.

    Wirkung

    Der Prototyp zeigt, wie sich unstrukturierte Texte systematisch für fachliche Fragestellungen erschließen lassen.

    PythonNLPSentiment Analysisstatistische ModellierungReporting
  8. 2014 – 2015

    Master of Science in Physik

    Universität des Saarlandes

    Thesis „Application of Machine Learning on the characterization of two-level systems“

  9. 2010 – 2014

    Bachelor of Science in Physik

    Universität des Saarlandes

Kompetenzen

Fünf Felder, ein durchgängiges System.

Daten, Anwendung, Automatisierung, KI und Betrieb greifen ineinander. Weil ich alle Ebenen selbst umsetze, entstehen keine Lücken zwischen Konzept, Code und Produktion.

Tech-Stack

Werkzeuge, die ich produktiv einsetze.

Ausgewählt nach Problem, nicht nach Vorliebe – von Cloud-Datenplattformen bis zu selbst betriebenen Modellen auf eigener Infrastruktur.

Kernwerkzeugnin dokumentierten Projekten

16Data Engineering und Plattformen

  • Python15
  • SQL7
  • PostgreSQL2
  • Spark3
  • PySpark
  • Databricks1
  • Azure Data Factory2
  • Azure Synapse Analytics1
  • Microsoft Fabric
  • AWS1
  • GCP
  • ETL/ELT
  • Data Warehouses
  • Lakehouses
  • Datenmodellierung1
  • Datenqualität1

16AI und Machine Learning

  • LLMs3
  • RAG3
  • LangChain1
  • LangGraph2
  • Hugging Face1
  • vLLM1
  • Ollama3
  • LiteLLM3
  • scikit-learn
  • PyTorch
  • TensorFlow
  • XGBoost
  • NLP2
  • Predictive Analytics1
  • Agentic AI1
  • semantische Suche

12Anwendungen und Integration

  • FastAPI5
  • REST APIs5
  • Docker5
  • n8n2
  • Nextcloud
  • Docmost1
  • Webhooks
  • Event-Workflows
  • Microservices
  • OAuth/OIDC
  • PostgreSQL2
  • Redis

08Analytics und Betrieb

  • Power BI5
  • Tableau1
  • Apache Superset1
  • Grafana1
  • Monitoring2
  • CI/CD2
  • Cloud · EU-Infrastruktur · On-Premises
  • Containerisierung1

51 Technologien · 3 Microsoft-Zertifizierungen · Cloud, EU-Infrastruktur oder On-Premises

Wissenschaftlicher Hintergrund

Physik als Fundament – Daten als Werkzeug.

Bevor Datenplattformen und KI-Systeme mein Alltag wurden, habe ich in der Physik gelernt, komplexe Daten statistisch sauber auszuwerten und Modelle kritisch zu prüfen. Das prägt meine Arbeit bis heute.

Abschluss: sehr gut

2017 – 2020

Promotion zum Dr. rer. nat. in Physik

Universität des Saarlandes und University of Wisconsin–Madison

run · tumble · run
Schematische Run-and-Tumble-Bewegung – das Muster, das ich in der Promotion statistisch analysiert habe.

Dissertation„Statistical analysis of bacterial locomotion“

Forschung an der Schnittstelle von Physik, Data Science und Machine Learning. Entwicklung statistischer und datengetriebener Methoden zur Analyse bakterieller Bewegungsmuster und zur Identifikation komplexer dynamischer Strukturen.

2023 – 2024

Master of Science in Data Science

IU International University of Applied Sciences

„Data-Science solution with a business approach“

2014 – 2015

Master of Science in Physik

Universität des Saarlandes

„Application of Machine Learning on the characterization of two-level systems“

2010 – 2014

Bachelor of Science in Physik

Universität des Saarlandes

Zertifizierungen

  • Fabric Analytics Engineer AssociateMicrosoft Certified
  • Azure Data Engineer AssociateMicrosoft Certified
  • Azure Data Scientist AssociateMicrosoft Certified
Arbeitsweise

Woran Sie die Zusammenarbeit erkennen.

  • 01

    Direkte Zusammenarbeit statt langer Übergabeketten

    Sie sprechen direkt mit der Person, die Ihr System entwirft und baut.

  • 02

    Technologieauswahl passend zum Problem

    Kein Lieblingswerkzeug – sondern das, was Ihre Anforderung am besten löst.

  • 03

    Verständliche Kommunikation mit Fachbereich und Technik

    Technische Entscheidungen so erklärt, dass Fachbereich und IT mitreden können.

  • 04

    Funktionsfähige Ergebnisse statt reiner Konzeptpapiere

    Am Ende steht etwas, das läuft und genutzt wird – nicht nur ein Foliensatz.

  • 05

    Nachvollziehbare und betreibbare Lösungen

    Dokumentiert, überwachbar und so gebaut, dass Ihr Team es weiter betreiben kann.

  • 06

    Bewusste Abwägung zwischen kommerziellen, offenen und selbst betriebenen Komponenten

    Kommerzielle Dienste, Open Source oder eigener Betrieb – bewusst abgewogen.

Nächster Schritt

Sprechen wir über Ihr Vorhaben.

Beschreiben Sie kurz, welche Daten, Prozesse oder KI-Idee Sie beschäftigen. Ich melde mich persönlich – mit einer ehrlichen Einschätzung, was sinnvoll ist und was nicht.

Fachartikel per E-Mail

Neue Artikel zu Datenplattformen, KI in Produktion und souveräner Technologie – etwa einmal im Monat. Kein Spam, Abmeldung jederzeit.